

Temps de lecture :
10 minutesDeep learning ou machine learning : quelle approche pour quel problème en entreprise ?
Le débat entre deep learning et machine learning revient dans chaque comité de pilotage IA. La question n’est pas académique : elle conditionne le budget, les délais, l’explicabilité et la soutenabilité d’un projet d’intelligence artificielle. Cet article tranche par cas d’usage, données disponibles et contraintes métier, pour les PME et ETI qui doivent choisir vite et bien.
Comparer machine learning et deep learning en un coup d’œil
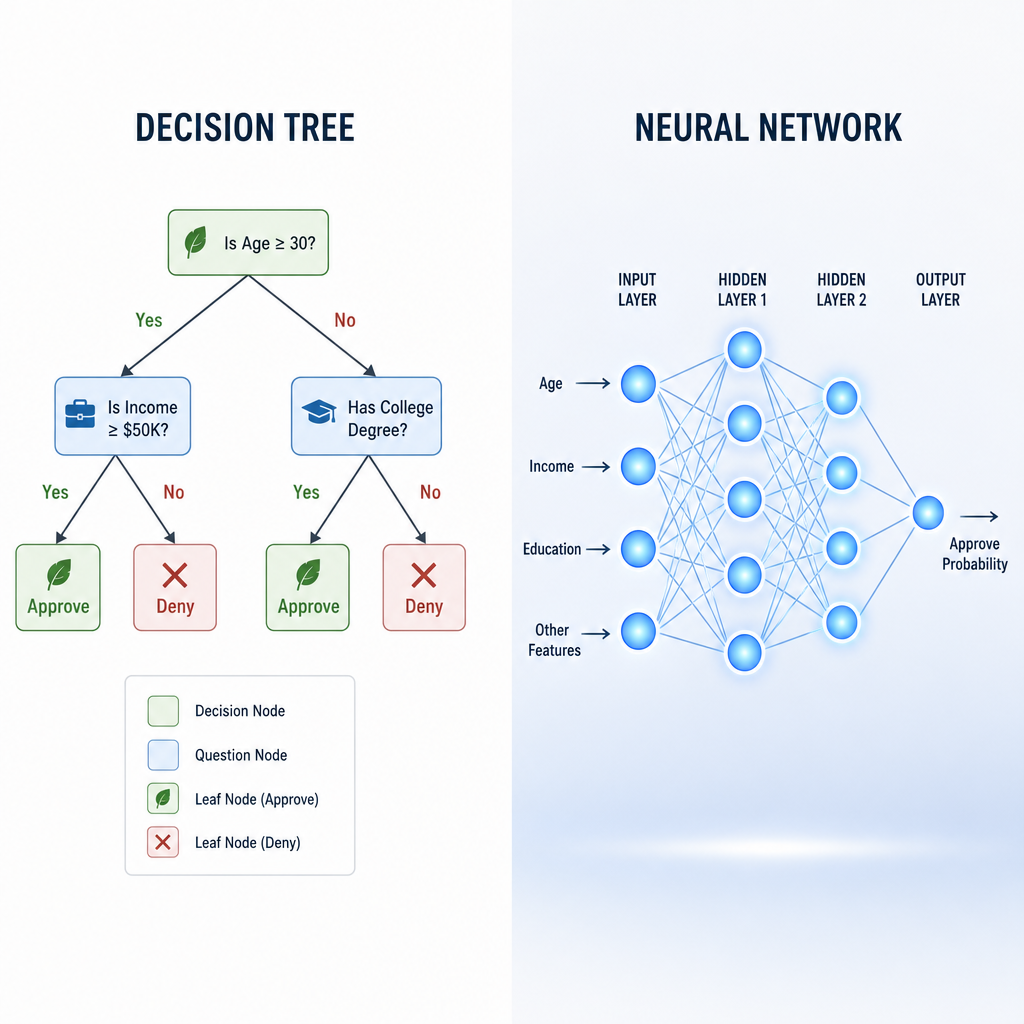
Ce tableau synthétise la comparaison entre machine learning et deep learning sur les critères qui comptent vraiment en entreprise : volume de données, infrastructure, explicabilité et typologie de problèmes traités. Il sert de première grille de lecture avant d’entrer dans le détail des cas d’usage.
- Données requises : ML, environ 50 à 100 points par variable ; DL, plusieurs milliers minimum.
- Infrastructure : ML, CPU standard ; DL, GPU dédiés.
- Explicabilité : ML, auditable ; DL, boîte noire partielle.
- Types de données : ML, tabulaire structuré ; DL, images, texte, audio.
- Temps d’entraînement : ML, minutes à heures ; DL, heures à semaines.
- Maintenance : ML, feature engineering récurrent ; DL, surveillance de dérive.
Machine learning : l’approche statistique pour structurer la donnée métier
Le machine learning en entreprise regroupe les algorithmes qui apprennent à partir de données structurées, sans programmation explicite des règles. La CNIL le définit comme un champ de l’intelligence artificielle visant à donner aux machines la capacité d’apprendre à partir de données via des modèles mathématiques. En pratique, le ML classique couvre une large part des besoins d’une PME : scoring, prédiction, classification tabulaire.
Présentation et principes de fonctionnement
Random forest, régression logistique, gradient boosting, SVM : ces algorithmes exigent un travail amont de feature engineering. L’expert métier identifie les variables pertinentes, nettoie, encode. Le modèle apprend ensuite les corrélations. Comptez environ 50 à 100 points de données par variable pour obtenir des résultats stables.
Forces en contexte entreprise
Les approches d’IA fondées sur le machine learning s’entraînent vite, tournent sur un serveur modeste et s’auditent ligne par ligne. Pour un dossier RGPD ou AI Act, cette traçabilité pèse lourd.
Limites et points de vigilance
Le feature engineering consomme une part majeure du temps projet. Et le ML plafonne sur les données brutes : images, sons, langage naturel.
Cas d’usage idéaux en PME et ETI
Scoring crédit, prédiction de churn, segmentation client, maintenance prédictive par machine learning, détection d’anomalies sur ERP. Les cas d’usage du machine learning dominent partout où la donnée est tabulaire et le volume modéré.
Deep learning : la puissance des réseaux de neurones pour les problèmes complexes
Le deep learning est un sous-ensemble du machine learning qui empile plusieurs couches de neurones artificiels inspirés du cerveau humain. Exploré en détail au début des années 2000 par Yann LeCun, Yoshua Bengio et Geoffrey Hinton, ce champ extrait seul les représentations utiles à partir de données brutes. Il alimente aujourd’hui des assistants comme Siri ou Alexa, les moteurs de recommandation de Google et les modèles génératifs.
Présentation et principes de fonctionnement
Un modèle de deep learning empile de nombreuses couches de neurones cachées. Le fonctionnement des réseaux de neurones repose sur l’ajustement itératif des poids via rétropropagation du gradient. Le besoin en données se compte en milliers de points par variable, bien au-delà des exigences d’un modèle ML classique.
Forces en contexte entreprise
Il absorbe les données non structurées, dépasse le ML sur la vision et le NLP, et ouvre la porte aux solutions d’IA générative pour l’entreprise. Les réseaux de neurones récurrents pour les séries temporelles traitent efficacement signaux et prévisions.
Limites et points de vigilance
Coûteux en GPU, gourmand en données, peu explicable. La latence d’inférence peut aussi bloquer un déploiement edge.
Cas d’usage idéaux, de la vision par ordinateur à l’IA générative
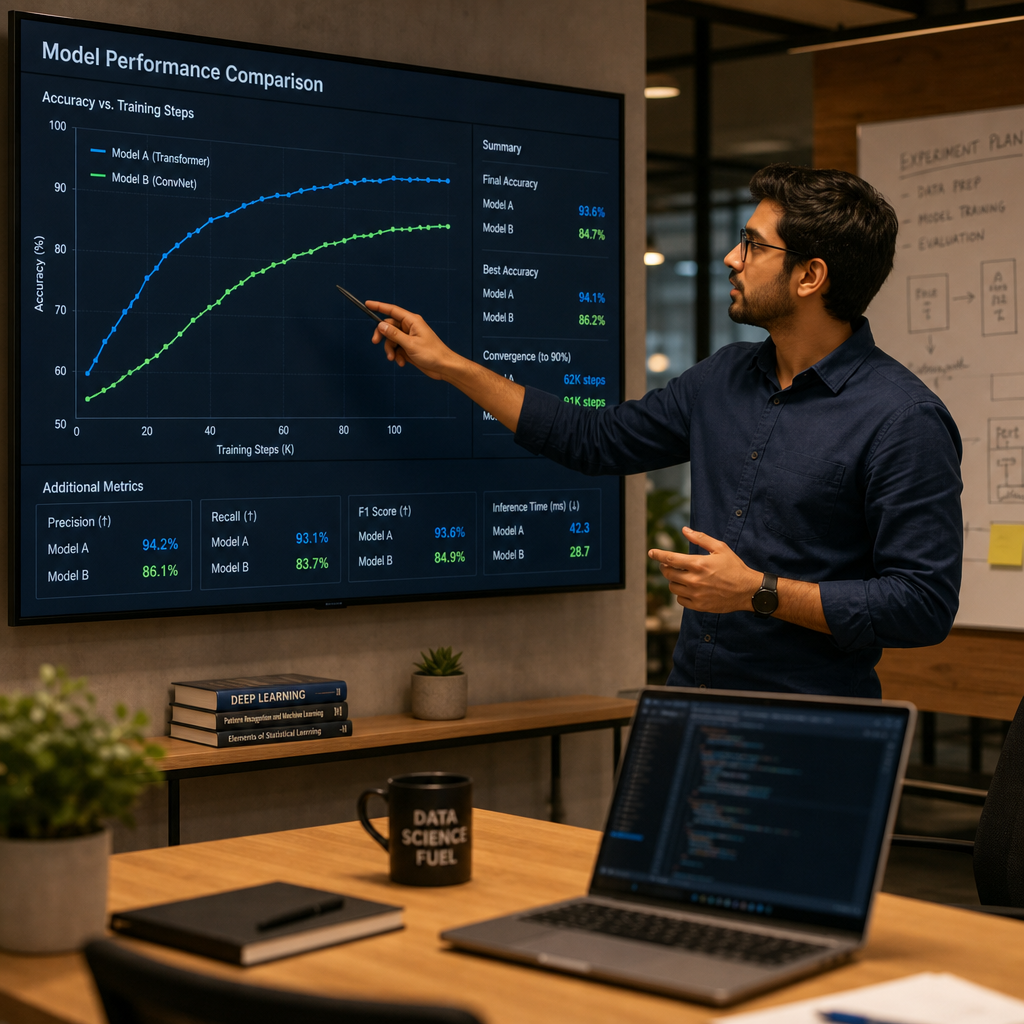
Détection automatique des fractures sur radiographie, conduite automatique chez Tesla, reconnaissance vocale, génération de texte, applications d’IA générative en entreprise. Les cas d’usage du deep learning se concentrent là où la donnée brute est riche et le volume massif. Plusieurs travaux récents comparent d’ailleurs ML et DL sur des terrains très différents : détection de maladies des feuilles de plantes (Sujatha, 2020), détection d’intrusions réseau (Ali, 2025), reconnaissance de monuments (Hesham, 2021), prévision des cours boursiers (Ghasemieh, 2021), détection audio de véhicules (Yoo, 2025), détection de nodules pulmonaires sur radios thoraciques (Perez-Diaz, 2025), détection de tumeurs cérébrales (Shivani, 2024) ou analyse de sentiment sur avis clients Amazon (Corak, 2025).
Comment choisir entre machine learning et deep learning : les vrais critères
La différence entre deep learning et machine learning se joue sur trois axes concrets : volume et nature des données, ressources techniques, exigence d’explicabilité. Aucun critère pris isolément ne tranche. C’est leur combinaison qui désigne le bon algorithme pour un contexte métier donné.
Volume et nature des données disponibles
Règle empirique : à faible volume de données étiquetées, le ML gagne presque toujours. Dès que l’on bascule sur des volumes se comptant en dizaines ou centaines de milliers d’exemples, surtout non structurés, le DL devient compétitif.
Ressources techniques, coûts et compétences internes
Un projet ML tient sur un cloud CPU modeste. Un entraînement DL sérieux exige des GPU dédiés et des compétences MLOps, avec un TCO sensiblement plus élevé sur la durée.
Niveau d’explicabilité exigé par le métier
Banque, assurance, santé, RH : l’AI Act exige une justification des décisions automatisées. Le ML reste roi dans ces secteurs. Le DL impose des couches d’explicabilité (SHAP, LIME) qui alourdissent la stack.
Quand utiliser le deep learning plutôt que le machine learning ?
La bascule n’est jamais automatique. Elle se justifie quand le ML classique plafonne malgré un feature engineering soigné, quand les données brutes deviennent exploitables à grande échelle, ou quand une tâche cognitive (vision, langage) devient centrale. Un audit IA pour identifier vos cas d’usage prioritaires évite les migrations inutiles.
Les signaux qui justifient de passer aux réseaux de neurones
- Performance du ML qui plafonne malgré les itérations.
- Volume de données brutes élevé, de l’ordre de plusieurs milliers d’exemples par variable.
- Besoin de traiter image, son ou texte libre.
- Budget GPU et compétences MLOps disponibles.
Le rôle émergent de l’apprentissage auto-supervisé dans cette bascule
Le self-supervised learning (ou apprentissage auto-supervisé) permet d’entraîner un modèle profond sur des données non étiquetées, puis de l’ajuster avec peu d’exemples labellisés. C’est le levier qui démocratise le deep learning dans les PME disposant de volumes bruts mais peu d’annotations.
Comment arbitrer concrètement selon votre problème d’entreprise ?
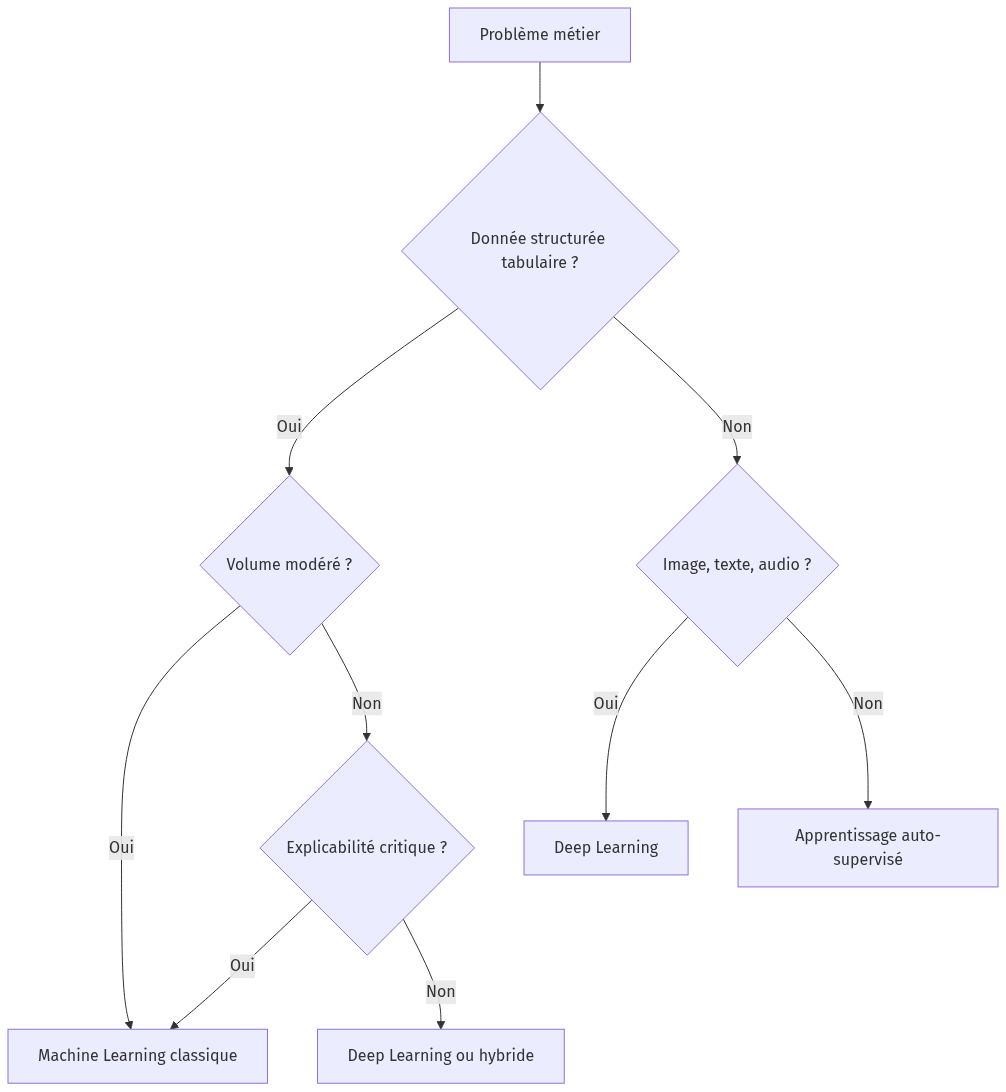
Trois questions suffisent : quel type de donnée (tabulaire ou brute), quel volume, quelle contrainte d’explicabilité. Les critères de choix entre chatbot et agent intelligent suivent la même logique pour les projets NLP.
Arbre de décision par type de projet
Approches hybrides et complémentarité des deux familles
Un pipeline mature combine souvent les deux : DL pour extraire des features visuelles, ML pour la décision finale explicable. Cette architecture hybride donne les meilleurs résultats sur les projets réglementés.
Notre recommandation : quel algorithme pour quel contexte
Choisissez le machine learning pour toute problématique tabulaire, réglementée ou à faible volume : scoring, détection de fraude par algorithme supervisé, prévision budgétaire. Choisissez le deep learning pour la vision, le langage naturel, la génération, dès que vous disposez du volume et des GPU. En cas de doute, commencez par un ML et validez la bascule par un benchmark chiffré.
« Le deep learning n’est pas une version plus puissante du machine learning : c’est un outil différent, pour des problèmes différents. »
– PredexIA
Les PME qui réussissent leur transition IA commencent presque toujours par un cas d’usage ML cadré, mesurable, auditable. Le deep learning vient ensuite, quand la maturité data et les volumes le justifient.
FAQ
Quelle est la vraie différence entre machine learning et deep learning en entreprise ?
Le machine learning apprend sur des données structurées préparées par un expert métier et reste auditable. Le deep learning apprend seul à partir de données brutes grâce à des réseaux neuronaux multicouches, mais exige des volumes massifs, des GPU et accepte une moindre explicabilité. En entreprise, le choix dépend du type de donnée et des contraintes réglementaires.
Machine learning ou deep learning : lequel choisir selon le volume de données ?
À faible volume d’exemples étiquetés, le ML surpasse quasi systématiquement le DL. Sur des volumes importants, surtout de données non structurées, le deep learning en entreprise prend l’avantage. Le volume de données reste le premier critère pour arbitrer entre machine learning et deep learning.
Le deep learning peut-il remplacer le machine learning classique dans une PME ?
Non, dans la majorité des cas. Une PME traite surtout des données tabulaires (ventes, clients, stocks) où le ML offre un meilleur ratio performance/coût et une explicabilité native. Un réseau de neurones en entreprise se justifie sur des cas précis : vision industrielle, chatbot avancé, applications d’IA générative. Pour tout le reste, le ML reste la référence des projets d’IA en PME et ETI.
Quel algorithme choisir pour un projet d’IA générative ?
L’IA générative repose exclusivement sur du deep learning, via des architectures de type transformer. Pour une PME, la question réelle n’est pas ML ou DL, mais fine-tuning d’un modèle existant ou simple appel API. Un algorithme de deep learning entraîné de zéro reste hors de portée budgétaire de la plupart des PME.
Sources
- Sujatha R. et al. (2020), Performance of deep learning vs machine learning in plant leaf disease detection.
- Ali M.L. (2025), Deep Learning vs. Machine Learning for Intrusion Detection in Computer Networks.
- CNIL / Les Échos Solutions, 3 minutes pour comprendre la différence entre deep learning et machine learning.
- Perez-Diaz M. (2025), Deep learning vs. machine learning in the detection of pulmonary nodules.
