


Préparation des données pour un projet d’intelligence artificielle : méthode et pièges
Un modèle d’intelligence artificielle vaut ce que valent ses données d’entraînement. Sur les projets d’IA que PredexIA audite en PME et ETI, entre 60 et 80 % du temps de mise en œuvre passe dans la préparation des données pour l’IA, rarement dans l’algorithme. Ce guide décrit les étapes, les livrables et les pièges de terrain, avec un regard direct sur la conformité AI Act et les interactions avec l’ERP métier.
Pourquoi la préparation des données est-elle décisive pour un projet d’intelligence artificielle ?
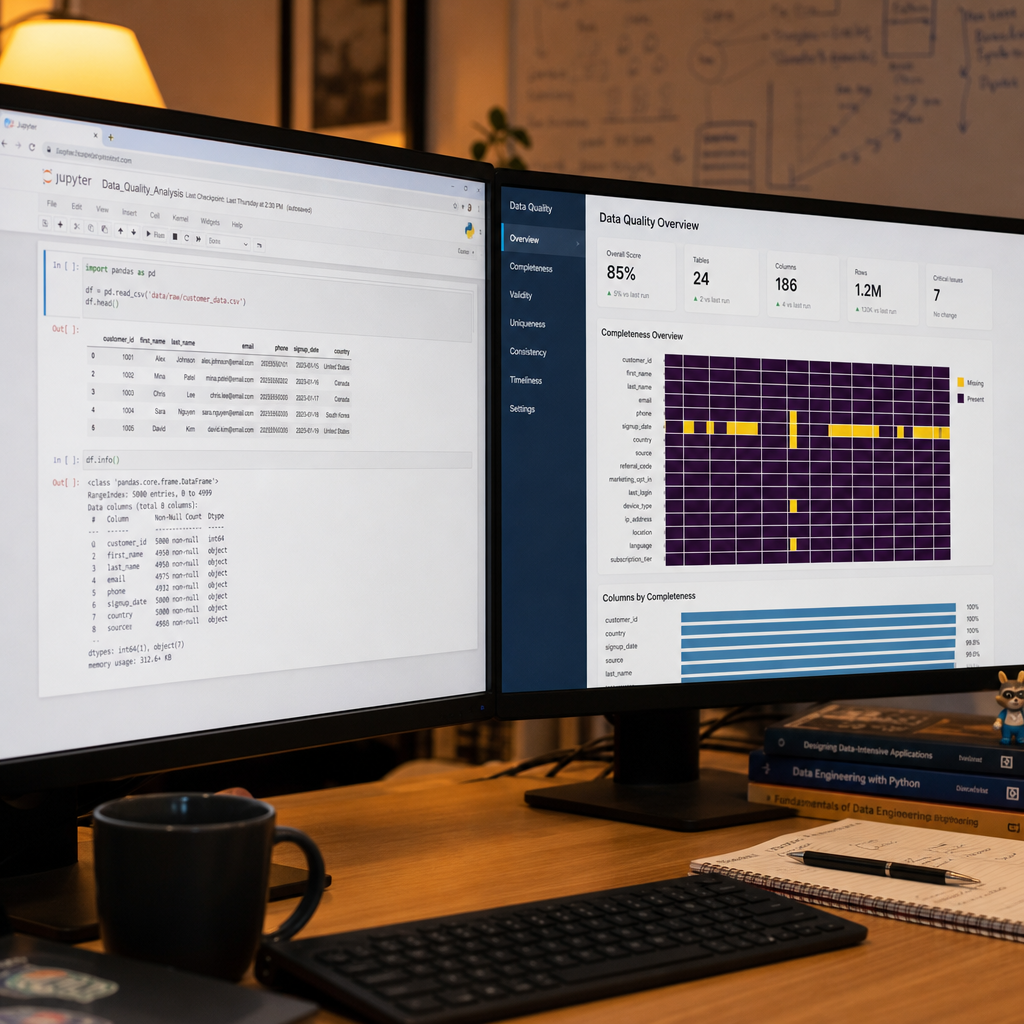
La préparation des données conditionne la performance, la fiabilité et la conformité d’un modèle. Un dataset propre, représentatif et documenté permet à un algorithme moyen de surpasser un algorithme de pointe entraîné sur des données bruitées. À l’inverse, des étiquettes ambiguës, des doublons ou des colonnes fuyantes produisent des scores flatteurs en laboratoire et des échecs en production. C’est aussi la phase où se joue la capacité à intégrer l’IA en entreprise sans friction.
L’impact direct de la qualité des données sur la performance des modèles
La science des données a établi un principe simple, souvent résumé par « garbage in, garbage out ». Les travaux de Giovanni Briganti (2023) sur l’IA clinique rappellent que la reproductibilité d’un modèle dépend d’abord de la traçabilité du jeu d’entraînement, pas de son architecture.
Les risques liés à des données mal préparées
Selon PredexIA, trois signaux d’alerte reviennent sur le terrain : un ERP qui exporte des libellés incohérents entre filiales, des dates au format mixte, et des identifiants clients dédoublonnés à la main. Chacun de ces défauts génère un biais silencieux que le modèle apprendra fidèlement.
Quelles sont les étapes clés pour préparer un dataset destiné à l’IA ?
La préparation d’un dataset pour l’IA suit une séquence à peu près stable : cadrage métier, collecte des données, exploration, structuration, nettoyage, annotation, découpage train/validation/test. Chaque étape produit un livrable réutilisable : schéma cible, dictionnaire de données, rapport de profilage, jeu étiqueté. Un accompagnement global vers l’intelligence artificielle aligne ces livrables sur le cas d’usage concret, plutôt que sur un idéal théorique.

Collecte et centralisation des sources de données
Collecter les données commence par cartographier les systèmes : ERP, CRM, fichiers plats, logs applicatifs, PDF métier. La collecte des données doit être documentée (source, fréquence, propriétaire, base légale RGPD).
Exploration et compréhension du jeu de données
Un rapport de profilage (pandas-profiling, ydata-profiling) révèle distributions, valeurs manquantes, corrélations suspectes. Étape non négociable : sans elle, le nettoyage devient de la superstition.
Structuration et formatage pour le machine learning
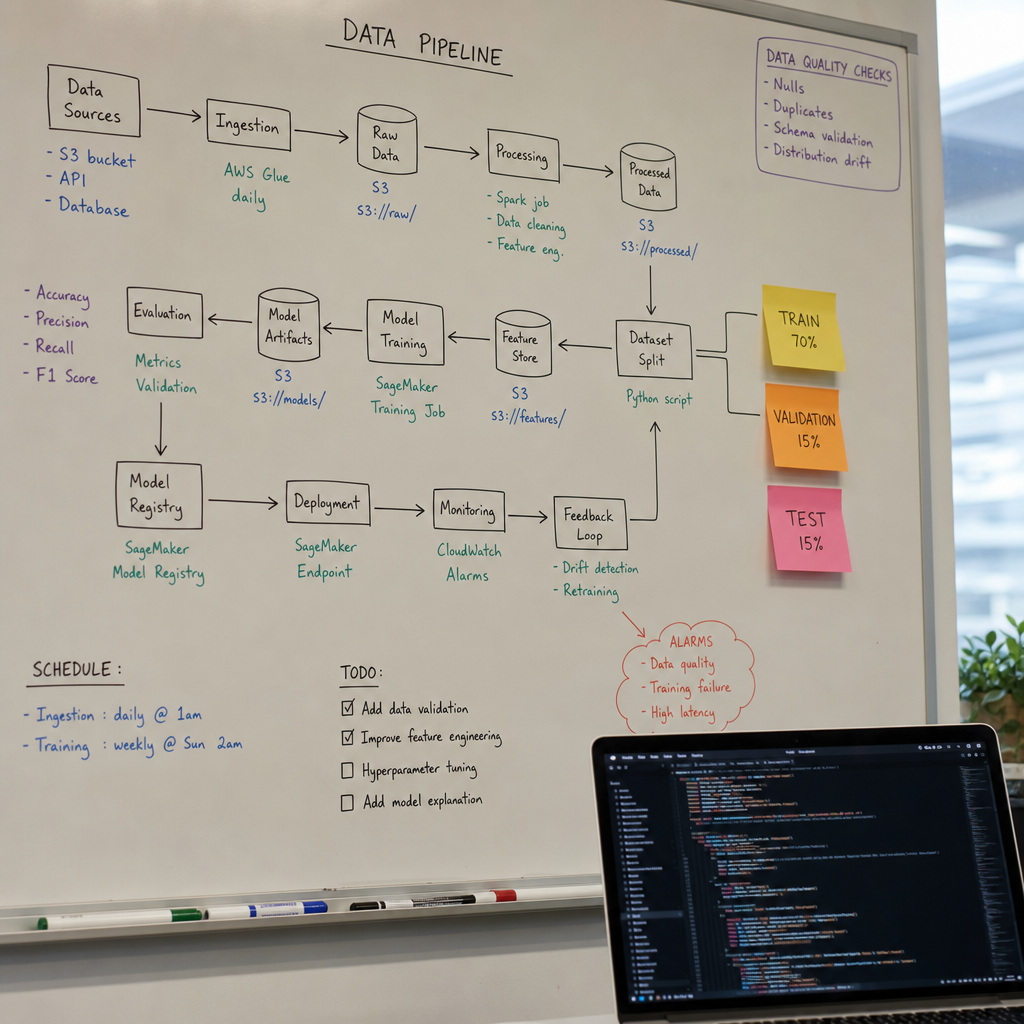
Les étapes de préparation des données pour le machine learning incluent typage strict, encodage des catégorielles, normalisation, découpage temporel pour les séries. Ratios usuels : 70/15/15 en classification tabulaire, 80/10/10 en NLP, avec validation croisée si le volume est faible (moins de 10 000 lignes).
Comment nettoyer efficacement une base de données pour le machine learning ?
Nettoyer une base de données pour le machine learning consiste à corriger, standardiser et documenter, jamais à effacer aveuglément. Le nettoyage des données pour le machine learning traite quatre familles de défauts : valeurs aberrantes, doublons, incohérences de format et données manquantes. PredexIA travaille avec ses experts en machine learning et modèles prédictifs pour arbitrer entre correction automatique et règle métier explicite, selon le coût d’une erreur en production.
Détection et traitement des valeurs aberrantes et doublons
Méthodes courantes : score Z, IQR, Isolation Forest, dédoublonnage par clé composite. Une aberration n’est pas toujours une erreur : parfois c’est le signal recherché (fraude, panne).
Comment gérer les données manquantes sans biaiser le modèle
La question « comment gérer les données manquantes en machine learning » n’a pas de réponse unique. Trois stratégies dominent :
- Suppression si le taux est faible (moins de 5 %) et les manquements aléatoires.
- Imputation (moyenne, médiane, KNN, MICE) si les manquements sont explicables.
- Encodage explicite de l’absence comme information (colonne « was_missing »).
Annotation et labellisation : constituer des données d’entraînement fiables
L’annotation de données pour l’IA reste la phase la plus sous-estimée. Elle transforme des données brutes en données d’entraînement exploitables par un modèle supervisé. Sa qualité se mesure par l’accord inter-annotateurs (kappa de Cohen supérieur à 0,7 comme seuil pragmatique). Pour un projet vision, voir la détection et classification d’objets dans les images.
Choisir la bonne stratégie d’annotation selon le type de projet
| Type de projet | Volume minimal | Méthode d’annotation | Outils |
|---|---|---|---|
| Classification tabulaire | 1 000-5 000 lignes | Règles + revue humaine | Label Studio, Argilla |
| NLP (classification texte) | 2 000-10 000 exemples | Double annotation | Prodigy, Doccano |
| Vision (détection) | 1 000-3 000 images | Bounding box + review | CVAT, Roboflow |
| RAG (documents) | 200-500 Q/R | Experts métier | Argilla, LangSmith |
Spécificités de la préparation des données pour le deep learning
La préparation des données pour le deep learning exige des volumes supérieurs et de l’augmentation (rotation, bruit, back-translation). Les spécificités du deep learning pour la préparation des données concernent aussi le rééquilibrage des classes minoritaires (SMOTE, oversampling ciblé).
Comment construire un pipeline de données solide et scalable ?
Un pipeline de données IA industrialisé automatise ingestion, validation, transformation et livraison du dataset. Il garantit reproductibilité, versioning et monitoring : trois conditions exigées, directement ou indirectement, par l’AI Act pour les systèmes à haut risque.
De l’ingestion brute au dataset prêt à l’entraînement
Étages classiques : bronze (données brutes), silver (nettoyées), gold (agrégées pour le modèle). Orchestration via Airflow, Prefect ou Dagster.
Automatisation, versioning et reproductibilité
Selon PredexIA, un projet sans versioning des données (DVC, LakeFS) devient impossible à auditer au bout de six mois. Le versioning conditionne la défense d’un modèle devant un auditeur AI Act.
Quels outils utiliser pour préparer ses données IA
Les outils de préparation des données pour l’intelligence artificielle se répartissent entre briques open source et plateformes intégrées. Le choix dépend du volume, de la sensibilité RGPD et de la maturité de l’équipe data. Le Baromètre PredexIA sur l’adoption de l’IA en entreprise française en 2026 rappelle que les investissements mondiaux des entreprises dans l’IA ont progressé de 80 milliards de dollars entre 2015 et 2022 (Statista), tirant l’offre outillage.
Solutions open source pour le nettoyage et la transformation
- pandas et DuckDB pour la manipulation tabulaire.
- Great Expectations pour la validation.
- DVC pour le versioning.
- Label Studio et Argilla pour l’annotation.
Plateformes end-to-end de data preparation pour l’intelligence artificielle
Databricks, Dataiku, Alteryx, AWS SageMaker Data Wrangler couvrent l’ingestion, la préparation et la traçabilité. Liste indicative : le marché évolue vite, porté par une croissance annuelle moyenne de 37,3 % du marché de l’IA entre 2023 et 2030 (Grand View Research).
Les meilleures pratiques pour garantir la qualité des données sur la durée
La qualité des données IA n’est pas un état, c’est un processus. Les meilleures pratiques de préparation des données pour l’IA reposent sur une gouvernance claire, un monitoring continu et une documentation vivante. C’est le socle d’une gouvernance IA durable et responsable, alignée avec les obligations de l’AI Act sur la traçabilité et la gestion des biais.
Mettre en place une gouvernance et un monitoring continu
Selon PredexIA, un data steward par domaine métier suffit dans une ETI, à condition qu’il dispose d’un tableau de bord de dérive (drift) mis à jour hebdomadairement.
Documenter, tester et itérer sur ses jeux de données
« La qualité d’un dataset se juge à la vitesse à laquelle un nouveau data scientist peut le comprendre sans nous poser de questions. » – PredexIA. Un dictionnaire de données, un README versionné et une suite de tests de non-régression suffisent à passer ce cap.
FAQ
Comment préparer les données pour un projet IA en pratique ?
Commencez par cadrer le cas d’usage avec le métier, puis inventoriez les sources (ERP, CRM, documents). Profilez le jeu, nettoyez, annotez si nécessaire, découpez en train/validation/test. Documentez chaque décision dans un data card. Le livrable final n’est pas seulement le dataset, c’est aussi le pipeline reproductible qui le régénère.
Comment évaluer la qualité des données destinées à un modèle d’IA ?
Six dimensions font consensus : complétude, unicité, cohérence, validité, fraîcheur, représentativité. Mesurez chacune avec des tests automatisés (Great Expectations, Soda) et fixez des seuils métier. Un dataset qui passe 95 % des tests mais échoue sur la représentativité produira un modèle biaisé, quelle que soit la sophistication de l’algorithme choisi.
L’AI Act change-t-il la préparation des données ?
Oui, pour les systèmes classés à haut risque. L’AI Act impose une gouvernance formelle des jeux d’entraînement : traçabilité des sources, gestion documentée des biais, examen des données pertinentes et représentatives. Concrètement, il faut versionner les datasets, documenter les choix de nettoyage et conserver les preuves pendant toute la durée de vie du système.


