

Temps de lecture :
9 minutesMachine learning : 10 questions-réponses pour comprendre vraiment
Le machine learning concentre les malentendus. Confondu avec l’intelligence artificielle, parfois réduit à ChatGPT, souvent survendu. Ces questions-réponses tranchent, sans jargon inutile, pour que PME et ETI arbitrent lucidement avant d’investir.
What is machine learning : qu’est-ce que c’est ?
Le machine learning est une discipline de l’intelligence artificielle qui apprend des régularités à partir de données plutôt que de suivre des règles codées à la main. Un modèle de machine learning ingère des exemples, ajuste ses paramètres par optimisation, puis généralise à des cas nouveaux. Cette capacité de généralisation, et non la mémorisation, constitue sa valeur réelle. Le terme remonte à Arthur Samuel, en 1959.
Définition et principes fondamentaux
La définition du machine learning tient en une phrase : construire une fonction qui minimise une erreur mesurée sur des données. Les probabilités sous-tendent toute la discipline. IBM rappelle que la probabilité est une mesure allant de 0 (impossible) à 1 (certain), et qu’un modèle de régression logistique produit par exemple une prédiction de 0,82 pour la probabilité qu’un client résilie.
Quelle différence entre intelligence artificielle et machine learning ?
L’intelligence artificielle et le machine learning ne sont pas synonymes. L’IA regroupe toutes les techniques qui simulent des fonctions cognitives, y compris les systèmes experts à base de règles. Le machine learning, lui, désigne l’approche statistique où le programme apprend des données. Toute IA n’est pas du machine learning, mais le ML alimente la plupart des IA utiles en entreprise aujourd’hui.
Comment fonctionne un modèle de machine learning ?
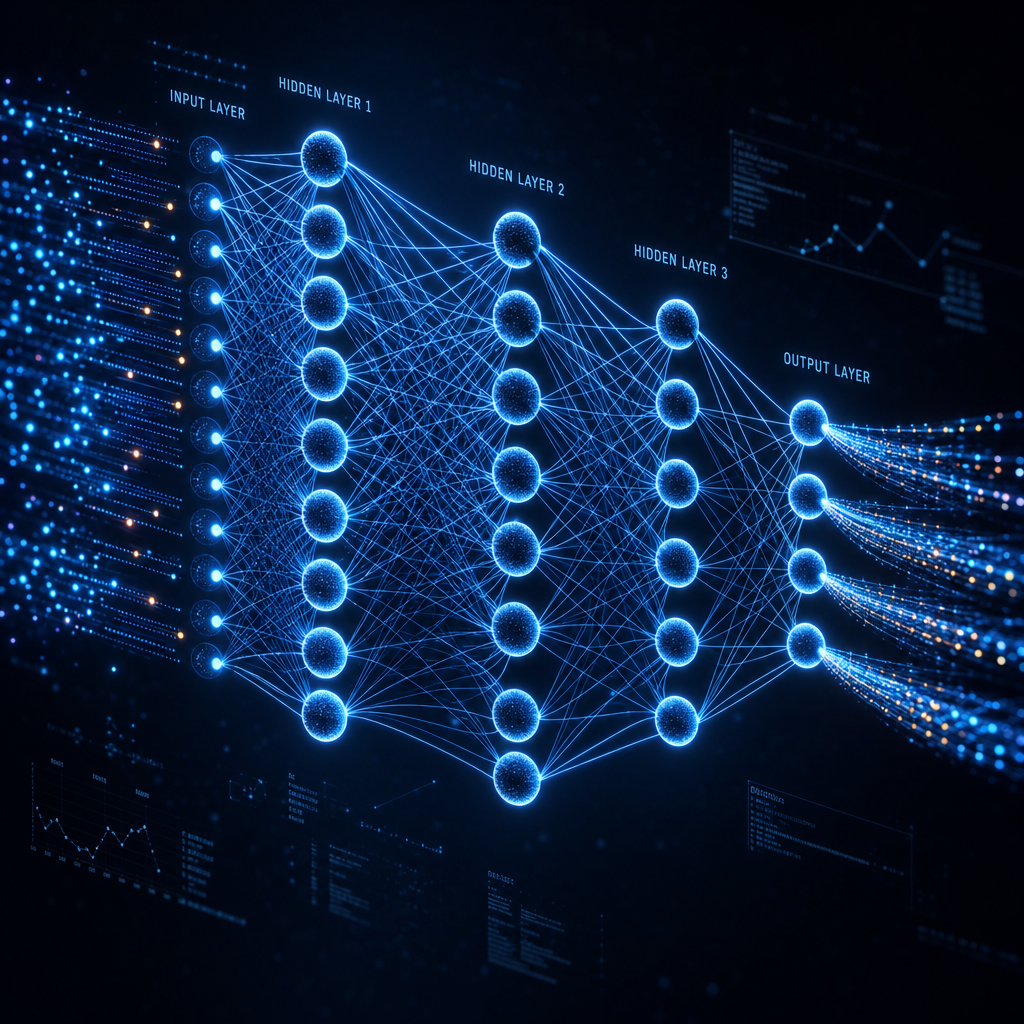
Un modèle apprend en trois phases : collecte et préparation des données, entraînement par optimisation, puis inférence en production. L’optimisation ajuste des millions de paramètres pour réduire une fonction de perte, le plus souvent via descente de gradient. Le modèle n’est jamais déployé seul : il s’inscrit dans un pipeline de données, un système de monitoring et un cycle de ré-entraînement périodique.
Les étapes clés : données, entraînement, prédiction
Un découpage typique répartit les données en 70 % entraînement, 15 % validation, 15 % test. Cette séparation permet de détecter le surapprentissage : un modèle qui mémorise au lieu de généraliser. Dans une distribution normale, rappelons que 68 % des valeurs se situent à moins d’un écart-type de la moyenne, un repère utile pour calibrer les métriques d’erreur. Pour les organisations qui veulent déléguer cette chaîne complète, nos développeurs IA spécialisés en modèles sur mesure prennent en charge la boucle entière.
Qu’est-ce qu’un algorithme d’apprentissage ?
Les algorithmes de machine learning sont les recettes mathématiques qui transforment des données en modèle. Régression linéaire, arbres de décision, forêts aléatoires, SVM, k-means, réseaux de neurones : chacun porte des hypothèses implicites sur la nature des données. Choisir un algorithme, c’est faire un pari informé sur ces hypothèses.
Quels sont les grands types d’apprentissage automatique ?
Le machine learning et le deep learning se déclinent en quatre familles : supervisé, non supervisé, auto-supervisé et par renforcement. La distinction tient à la nature du signal d’apprentissage. Avec étiquettes humaines, sans étiquettes, avec étiquettes générées par les données elles-mêmes, ou via récompenses issues d’un environnement. Chaque famille résout des problèmes différents.
Apprentissage supervisé : prédire à partir d’exemples étiquetés
L’apprentissage supervisé apprend une fonction entrée-sortie à partir de paires annotées. Détection de fraude, scoring crédit, diagnostic médical, prévision de churn.
Apprentissage non supervisé et auto-supervisé : détecter des structures cachées
Le machine learning non supervisé cherche des structures sans étiquettes : segmentation client, détection d’anomalies, réduction de dimension. L’apprentissage auto-supervisé, lui, fabrique ses propres étiquettes à partir des données brutes – c’est la méthode qui a entraîné GPT, BERT et les modèles de vision récents.
Apprentissage par renforcement : apprendre par essais et récompenses
Le reinforcement learning entraîne un agent qui interagit avec un environnement et maximise une récompense cumulée. Robotique, trading algorithmique, optimisation logistique, jeux. Coûteux en données simulées, mais puissant quand la boucle action-conséquence est bien définie.
Supervisé vs non supervisé : comment choisir la bonne approche ?
Le choix entre apprentissage supervisé et non supervisé se joue sur une question simple : disposez-vous d’étiquettes fiables ? Si oui, et si la cible métier est claire (une catégorie, un score, une valeur), le supervisé gagne. Sinon, l’approche non supervisée explore et segmente. Un comparatif rapide des deux familles :
| Critère | Supervisé | Non supervisé |
| — | — | — |
| Données | Étiquetées | Brutes |
| Objectif | Prédire | Découvrir |
| Évaluation | Métriques directes (accuracy, F1) | Interprétation métier |
| Cas typiques | Scoring, classification | Segmentation, anomalies |
Pour approfondir ce choix stratégique, consultez notre page dédiée à l’apprentissage supervisé et non supervisé.
Deep learning et machine learning : quelles différences ?
La différence entre deep learning et machine learning tient à l’architecture et au volume de données. Le ML classique s’appuie sur du feature engineering humain et fonctionne avec quelques milliers d’exemples. Le deep learning apprend ses représentations seul, mais exige des volumes massifs et une puissance GPU conséquente. L’un n’est pas supérieur à l’autre – ils résolvent des problèmes différents.
Qu’est-ce que le deep learning ?
Définition du deep learning : un sous-ensemble du ML utilisant des réseaux de neurones à plusieurs couches, entraînés par rétropropagation du gradient. Janiesch et al. détaillent comment ces architectures ont supplanté le ML classique sur l’image, l’audio et le texte.
Quand privilégier les réseaux de neurones profonds ?
Volume de données important, signal non structuré (image, texte, série temporelle), ressources de calcul disponibles. Pour les séries temporelles, les modèles séquentiels LSTM pour données temporelles restent une référence pratique.
Quels sont les cas d’usage concrets du machine learning ?
Les cas d’usage concrets couvrent toutes les fonctions d’entreprise : marketing, finance, opérations, support, R&D. La maturité technique est atteinte ; le frein est désormais organisationnel. Les PME qui réussissent commencent par un cas d’usage à ROI mesurable sous 6 mois, puis industrialisent.
Traitement du langage naturel (NLP) et IA conversationnelle
Le NLP, branche du machine learning, anime les chatbots, les moteurs de recherche internes, l’analyse de verbatim client, la synthèse automatique. Voir notre expertise en IA conversationnelle et agents intelligents en entreprise.
Vision, recommandation et détection d’anomalies
Vision industrielle pour le contrôle qualité, moteurs de recommandation produit, maintenance prédictive, détection de fraude par algorithme supervisé. Et plus largement, les cas d’usage de l’automatisation IA en entreprise.
Comment se lancer en machine learning avec Python ?
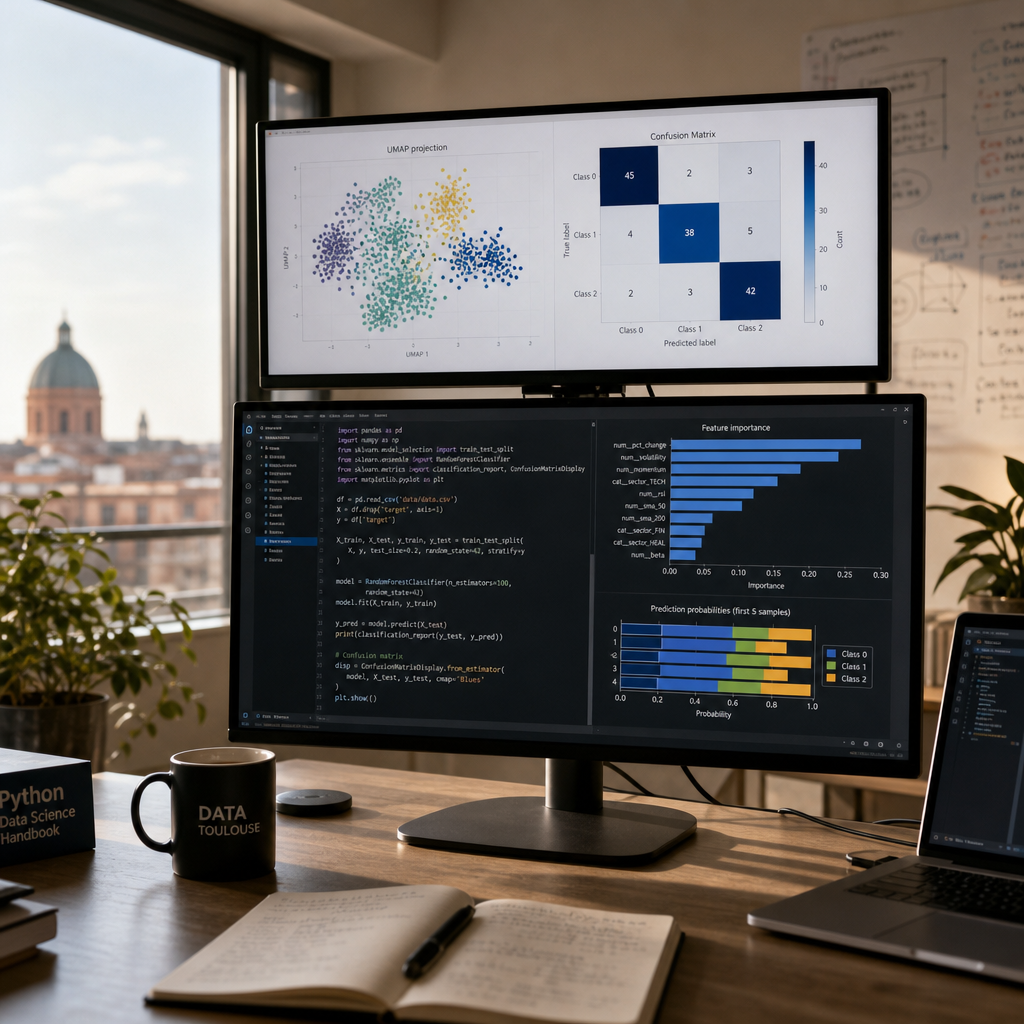
Python s’est imposé comme standard de fait pour le machine learning. Un parcours réaliste combine une base statistique, la maîtrise d’une bibliothèque, un projet personnel bout-en-bout, puis une mise en production. Compter 6 à 12 mois pour atteindre un niveau opérationnel. Le travail d’un ingénieur ML junior utile en production relève majoritairement d’ingénierie logicielle, la modélisation ne venant qu’ensuite.
Les bibliothèques incontournables (scikit-learn, TensorFlow, PyTorch)
Parmi les plus utilisées :
- scikit-learn : ML classique, pipelines, prototypage rapide
- PyTorch : deep learning, recherche, production
- TensorFlow : deep learning, déploiement industriel, mobile
- XGBoost : gradient boosting, tabulaire
- Hugging Face : NLP, modèles pré-entraînés
Côté recherche appliquée, l’article d’état de l’art de L. Oudre, C. Truong et N. Vayatis sur la détection de ruptures a dépassé les 1000 citations en trois ans, et la librairie Python associée avoisine les 20 millions de téléchargements – un signe que l’écart entre labo et production s’est réduit.
Un parcours d’apprentissage pas à pas pour débutants

Franchir la dernière étape – passer du notebook à la production – est le vrai saut. Voir notre offre d’industrialisation d’un projet IA en production.
FAQ
Qu’est-ce que le machine learning et comment le définir simplement ?
Le machine learning est une méthode qui permet à un programme d’apprendre à partir d’exemples au lieu de suivre des règles écrites à la main. Il ajuste ses paramètres pour minimiser une erreur mesurée, puis applique ce qu’il a appris à des données nouvelles. Sa valeur tient à sa capacité de généralisation, pas à la mémorisation.
Quelles compétences faut-il pour devenir ingénieur en machine learning ?
Trois socles : programmation (Python, SQL, Git), mathématiques appliquées (statistiques, algèbre linéaire, optimisation), et ingénierie logicielle (tests, CI/CD, cloud, conteneurs). S’y ajoutent la curiosité métier et la capacité à cadrer un problème avant de modéliser. La modélisation pure représente moins d’un tiers du métier réel en entreprise.
Quelles sont les applications concrètes du machine learning aujourd’hui ?
Détection de fraude bancaire, recommandation produit, maintenance prédictive industrielle, scoring crédit, segmentation client, vision pour contrôle qualité, traitement de documents, chatbots, prévision de demande, personnalisation marketing, diagnostic médical assisté. Chaque secteur a ses cas prioritaires, mesurables sous 6 à 12 mois dans la plupart des PME.
